

A DeepSeek aposentou o V4-Pro e colocou o V4.1-Flash no lugar dele na API. A mudança vale para quem já roda agentes em produção, porque mexe em preço, cache e rota de requisições ao mesmo tempo.
Se você mantém integrações com deepseek-v4-pro ou deepseek-v4-flash, o relógio começou a contar: as novas regras entram em vigor em datas específicas de setembro de 2026.
Arquitetura assimétrica e o fim do V4-Pro
O V4.1-Flash é um MoE de 552B parâmetros, ou seja, um modelo com muitos especialistas dos quais só uma fração é ativada por token. A novidade está na arquitetura Causal Encoder–Decoder: são apenas 8B parâmetros ativos na entrada e 16B na saída.
Essa assimetria reduz o custo de processar o prompt sem abrir mão da qualidade na geração.
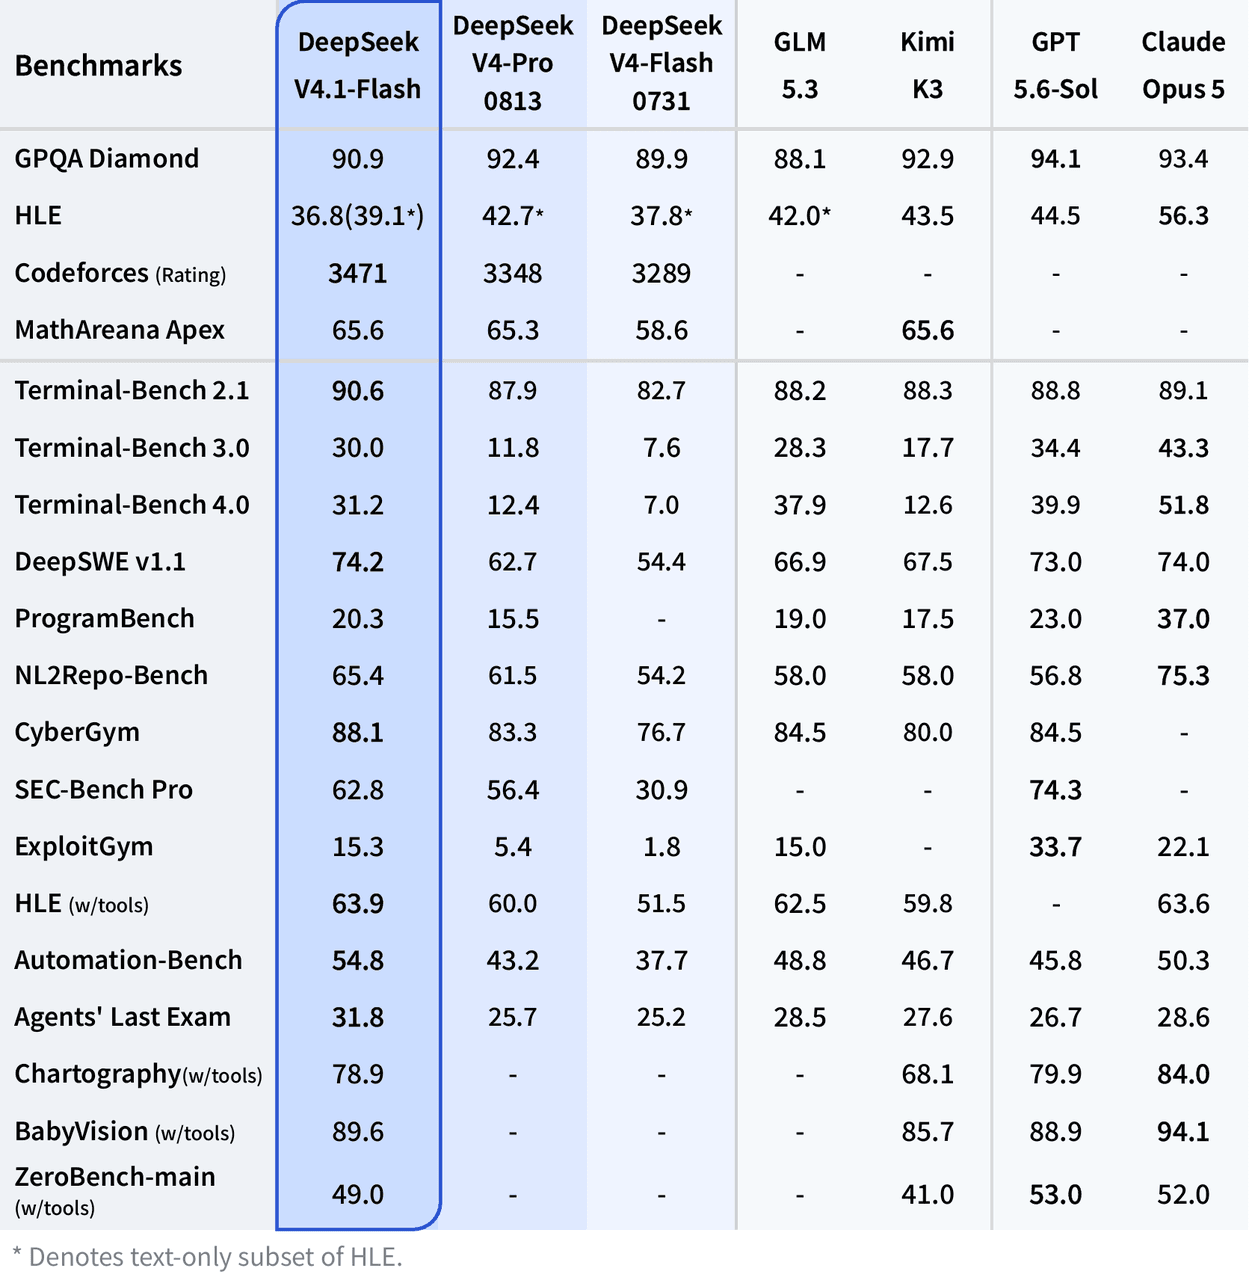
Segundo a DeepSeek, os novos métodos de pré-treinamento e o pós-treinamento com RL em escala maior colocam o V4.1-Flash à frente de modelos flagship, incluindo o DeepSeek-V4-Pro. Testes feitos por várias partes independentes apontam vantagem em desempenho, custo, velocidade e tempo total de execução. Por isso a empresa está descontinuando o V4-Pro de forma gradual.
Cache menor, economia maior
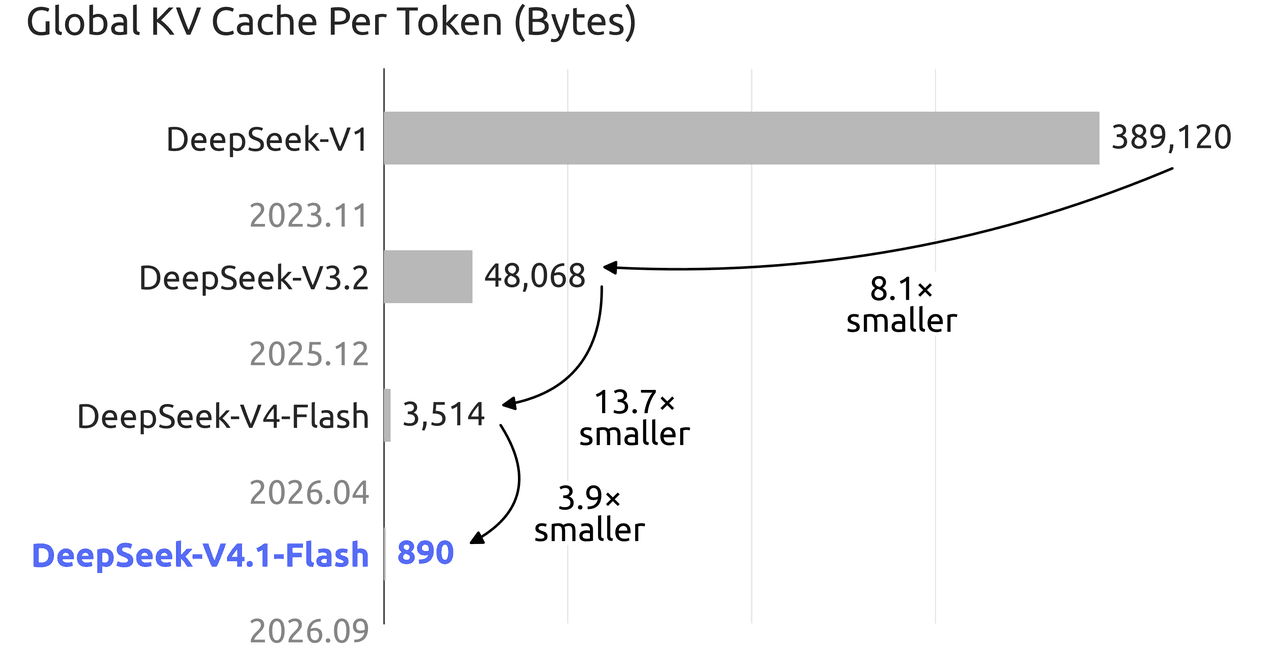
O KV cache é a memória que guarda as chaves e valores já processados de um contexto, evitando recomputar tudo a cada novo token. No V4.1-Flash, esse cache precisa de 1/4 da HBM e 1/8 do armazenamento em SSD na comparação com a geração anterior.
HBM é a memória de alta largura de banda usada pelas GPUs.
Essa compressão importa porque cobranças por cache-hit costumam representar uma fatia grande do custo de agentes. Quando o cache encolhe, o provedor gasta menos para manter contexto vivo e repassa parte disso.
Para quem roda fluxos longos com muitas chamadas encadeadas, o efeito no orçamento mensal tende a aparecer rápido.
Migração da API e suporte multimodal
O V4.1-Flash já está no ar na API DeepSeek com suporte multimodal nativo. Basta apontar o modelo para deepseek-flash.
Os modelos V4-Flash e V4-Flash-Vision-Exp foram retirados, mas deepseek-v4-flash e deepseek-v4-flash-vision-exp ainda roteiam temporariamente para o V4.1-Flash por compatibilidade.
A partir das 04:00 UTC de 14 de setembro de 2026, todas as requisições para deepseek-v4-pro passam a ser roteadas para o V4.1-Flash, com as tarifas do V4.1-Flash. Esse arranjo segue até o lançamento do V4.1-Pro. Parceiros oficiais como WorkBuddy, incluindo o CodeBuddy, e OpenCode já suportam o novo modelo.
Preços e janelas de demanda
A nova tabela de preços entra em vigor às 04:00 UTC de 10 de setembro de 2026. O modelo de peak/off-peak continua, e as tarifas off-peak ficam em 50% das tarifas de pico.
Vale agendar cargas flexíveis fora do horário de maior demanda para capturar essa diferença.
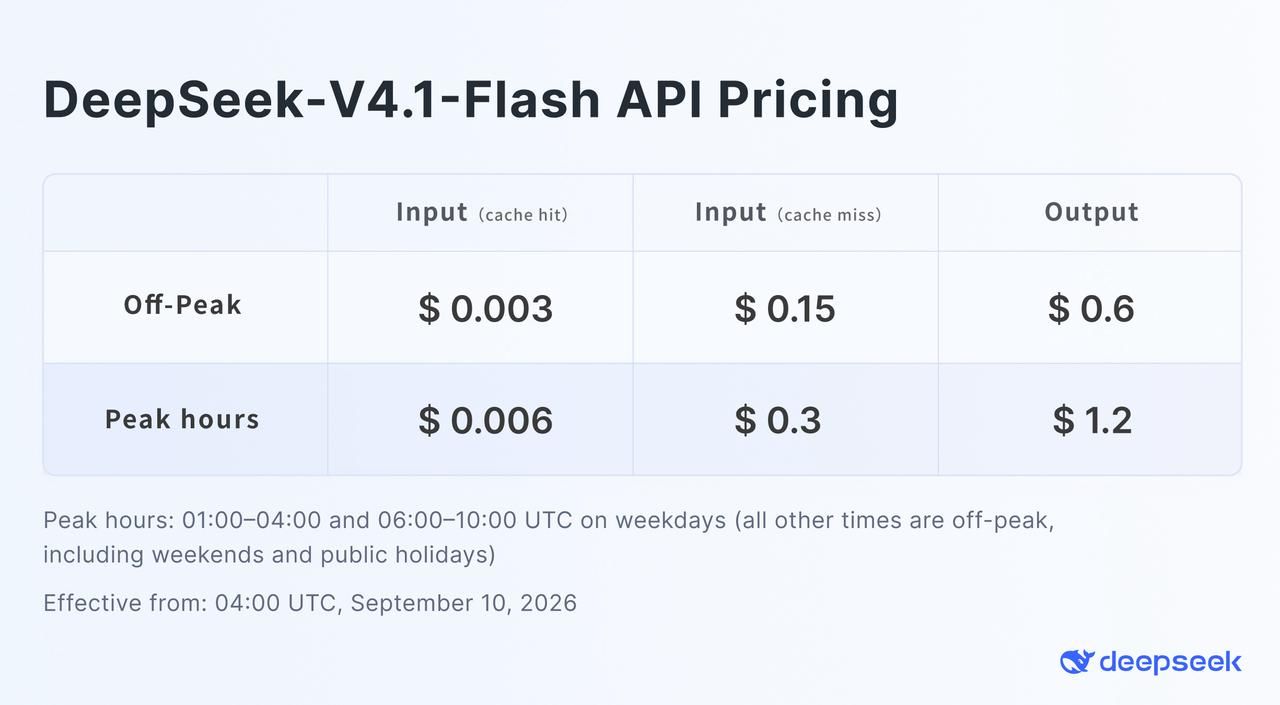
A DeepSeek afirma que a arquitetura mais eficiente permite atender mais usuários a um custo menor, e diz estar repassando essa economia. Para equipes que comparam provedores, o cálculo relevante não é só o preço por milhão de tokens, mas o custo total do agente somando cache-hit, retries e tempo de execução.
Open source e implantação em escala
A empresa diz que vai trabalhar junto à comunidade open source no suporte de inferência do V4.1-Flash e explorar mais opções de implantação. Quem planeja uma implantação em larga escala com 2.000 GPUs ou mais, junto de um cluster de armazenamento, pode conversar diretamente com a DeepSeek.
O modelo está disponível no Hugging Face em deepseek-ai/DeepSeek-V4.1-Flash, e o relatório técnico acompanha o repositório. Para quem depende da API hospedada, o caminho prático é trocar o nome do modelo para deepseek-flash, revisar a fatura depois de 10 de setembro e conferir se algum fluxo ainda aponta para identificadores antigos antes de 14 de setembro.


