

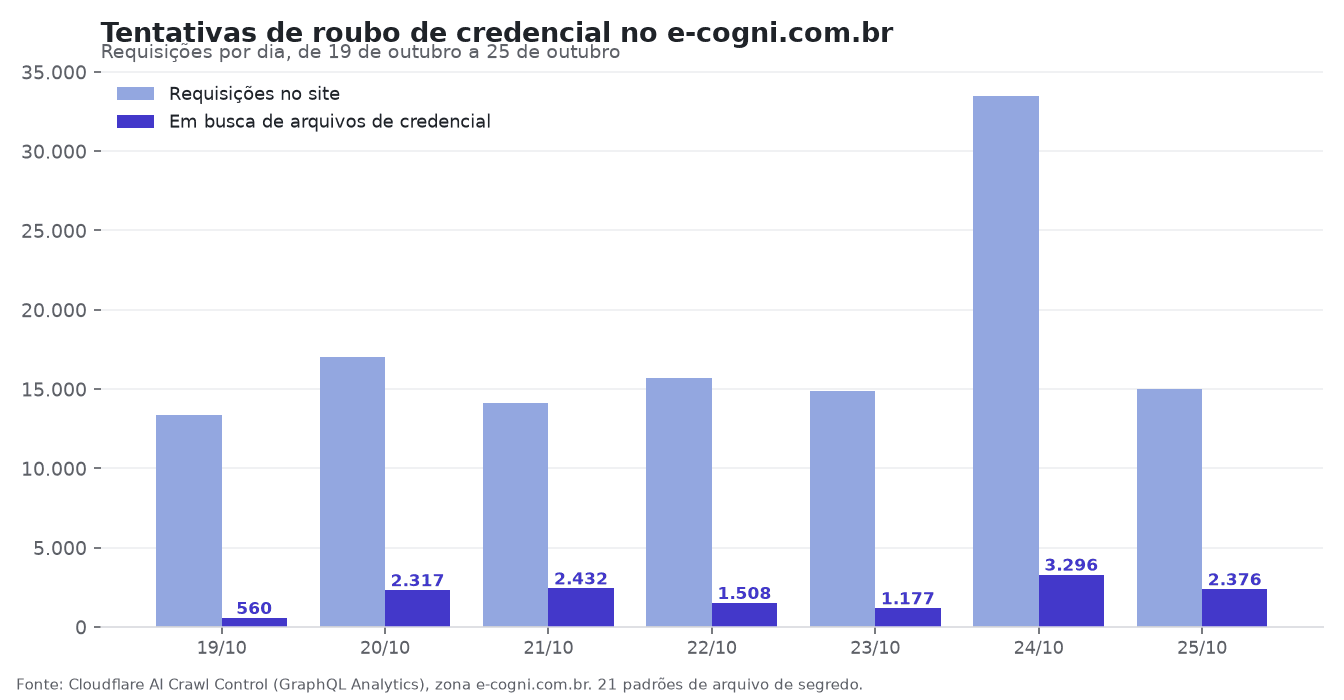
Na semana de 19 a 25 de outubro de 2026, o domínio recebeu 123.532 requisições, número levemente menor que o da semana anterior. O volume de acessos a caminhos de arquivos de credencial chegou a 13.666, ou 11,06% do total.
O dado mais relevante é que 2.909 dessas tentativas vieram identificadas com nomes de crawlers conhecidos, mas só 8 estavam associadas a bots reconhecidos e verificados pela Cloudflare.
A proporção de tentativas de credencial usando nomes de robôs conhecidos aumentou em relação à semana passada, ainda que o total absoluto tenha recuado. Já a presença efetiva de bots legítimos seguiu insignificante, o que reforça a suspeita sobre a origem desses acessos.
O padrão ficou claro: nomes de crawlers de inteligência artificial são usados como fantasia por scanners automatizados, sem relação real com indexadores públicos.
Quem vestiu o nome de quem
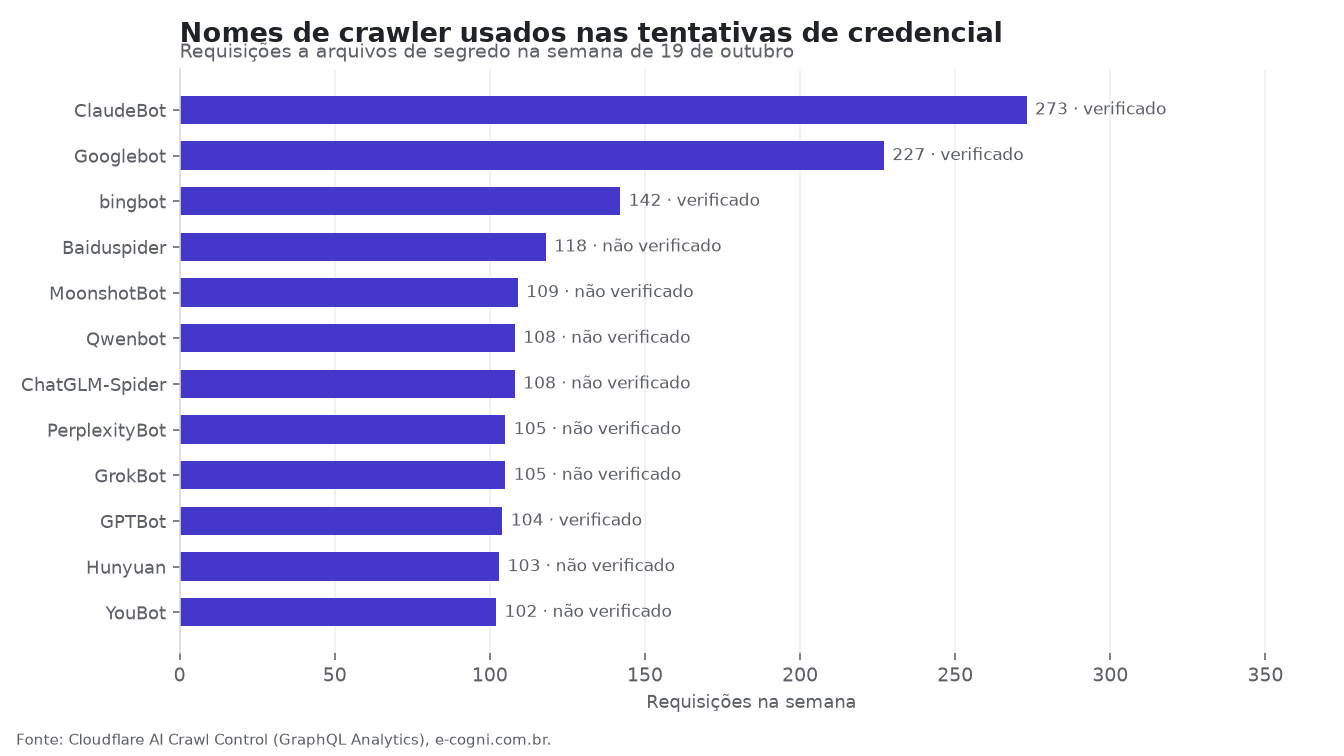
Na semana passada, oito nomes de bots apareceram em tentativas de acessar caminhos de credencial do e-cogni.com.br. O nome mais usado foi ClaudeBot, aparecendo em 273 dessas requisições, seguido por Googlebot com 227 tentativas, e bingbot com 142.
Outros nomes observados foram Baiduspider (118), MoonshotBot (109), Qwenbot (108), ChatGLM-Spider (108) e PerplexityBot (105). No total, crawlers de IA fizeram 2.318 requisições a caminhos de credencial, enquanto buscadores legítimos ficaram em 591 dessas tentativas.
A verificação de bot da Cloudflare praticamente não aparece nessas rotas sensíveis. Das 1.190 tentativas de credencial feitas usando esses nomes de crawler, apenas 8 foram marcadas com verificação da Cloudflare.
Isso indica que quem conduz essas tentativas sabe evitar mecanismos básicos de detecção automatizada implementados pelo provedor.
Um nome de robô nada mais é do que um cabeçalho HTTP enviado pelo cliente. Qualquer script pode informar o nome que quiser ao fazer uma requisição.
A escolha por nomes conhecidos, como Googlebot ou ClaudeBot, visa confundir logs e, ocasionalmente, burlar regras superficiais de firewall. O uso recorrente desses nomes evidencia que ataques automatizados estão cada vez mais explorando a reputação dos crawlers estabelecidos para ocultar movimentações maliciosas.
De onde vinham
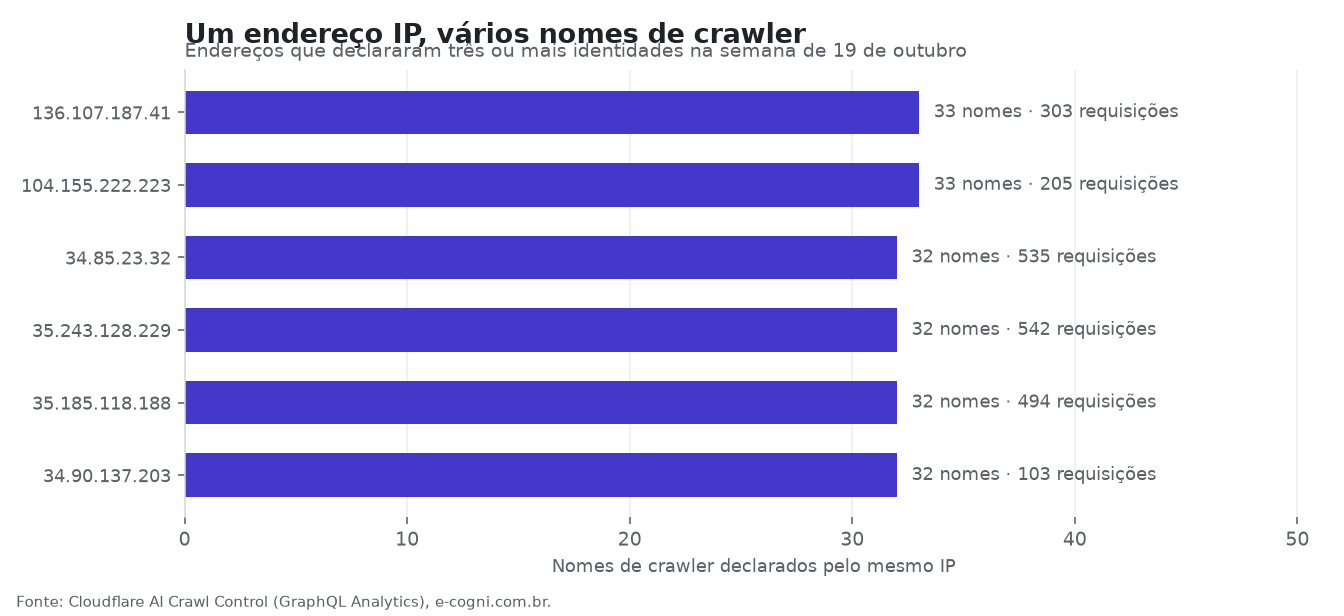
Oito endereços IP se destacaram por declarar três ou mais nomes diferentes de rastreadores durante a semana, todos ligados a nuvens públicas. O IP 136.107.187.41, nos Estados Unidos, apresentou o maior número: 33 nomes distintos em 303 requisições; já o endereço 104.155.222.223, em Taiwan, repetiu o padrão de 33 nomes, mas com 205 tentativas.
No Japão, o IP 34.85.23.32 declarou 32 nomes diferentes e foi responsável por 535 requisições, número próximo ao do IP 35.243.128.229 nos Estados Unidos, com 542 chamadas e 32 nomes. Outros dois endereços americanos — 35.185.118.188 e 34.90.137.203, também variaram nomes de crawler, mas se diferenciaram na intensidade: enquanto o primeiro chegou a 494 requisições, o segundo registrou apenas 103, já com 32 nomes diferentes.
Esses registros indicam que cada endereço IP foi utilizado para simular diversos rastreadores, com listas de nomes quase idênticas, e não houve sobreposição de nomes entre IPs distintos. Não apareceu nenhum endereço compartilhado por mais de um grupo de nomes, o que mostra que, apesar da camuflagem, os operadores mantêm faixas de IP separadas para cada instância.
O que eles procuravam
Os robôs concentraram buscas em arquivos de ambiente e credenciais. O padrão env foi o mais solicitado, com 9.691 requisições, seguido por credential (1.054) e git (884).
Caminhos exatos como www.e-cogni.com.br/.git/config (262 requisições) e www.e-cogni.com.br/.env (147) lideraram as tentativas, indicando escaneamento automatizado em busca de variáveis sensíveis.
Houve insistência em variantes de arquivos de ambiente, como .env.production (77), .env.local (67) e .env.bak (45), além de múltiplas versões do endereço principal e subdiretórios. Outras extensões visadas incluíram config_json, ssh e docker_compose, todos com mais de 150 tentativas cada.
Essas buscas refletem padrões comuns de ataques automatizados contra aplicações web em produção.
Entre as explorações, houve 546 requisições tentando leitura arbitrária de arquivos via falha conhecida do Vite (CVE-2025-30208, usando /@fs/), 139 tentativas de acesso ao /proc/self para sondagem de contêiner e 23 acessos ao caminho de editor de código exposto (/icecoder). Nenhum desses arquivos ou endpoints existe no servidor, o site é estático, sem backend exposto.
O que fazer com isso
Robôs declarados como Googlebot, Bingbot e BaiduSpider acessaram o site, mas o nome é apenas uma informação enviada pelo próprio cliente na requisição. Não houve validação automática do endereço IP contra as faixas oficiais desses buscadores, o que deixa espaço para falsificação.
Os scanners automatizados fizeram requisições a arquivos sensíveis como .env, .git e dumps de banco de dados, exibindo padrões claros de varredura. Nenhuma dessas tentativas foi seguida de bloqueio ou geração de alerta.
Tentativas de login com credenciais conhecidas ou padrões não passaram por verificação de bot, deixando ataques automatizados indistinguíveis de acessos legítimos.
Implemente validação do endereço IP de cada robô declarado, conferindo sempre contra a faixa oficial publicada por cada fornecedor de buscador. Não confie apenas no nome do agente informado; bloqueie ou alerte caso o IP não pertença ao intervalo correto.
Configure monitoramento para toda tentativa de acesso a arquivos de configuração sensíveis, cada tentativa deve acionar alerta imediato. Nunca mantenha arquivos como .env, .git ou cópias de banco de dados em diretórios públicos, sob qualquer hipótese.
Revise os logs para identificar quais caminhos e falhas os scanners procuram e corrija as exposições possíveis. Ao decidir liberar acesso a robôs, faça a checagem pelo IP, nunca só pelo nome.
Como medimos
Os dados vêm da API GraphQL Analytics da Cloudflare, no conjunto httpRequestsAdaptiveGroups, o mesmo que alimenta o painel AI Crawl Control. A semana vai de 19 de outubro a 25 de outubro e a coleta é feita dia a dia, porque a API aceita janelas de 24 horas por consulta e a zona gratuita guarda 31 dias de histórico.
Classificamos como caminho de credencial 21 padrões de arquivo de segredo, de .env e .aws/credentials a chave privada, dump de banco e cofre de senha. Só requisições de cliente real, cada uma contada uma vez.
Duas ressalvas. A categoria de bot verificado da Cloudflare não cobre todos os crawlers que existem, então a ausência dela não condena um nome sozinho: o que condena é o conjunto, com o mesmo endereço assinando dezenas de nomes e uma lista de arquivos que só interessa a quem quer senha.
E user-agent, por definição, é o que o cliente escolhe dizer.
Os gráficos são feitos pelo E-Cogni com os dados brutos da coleta.


