

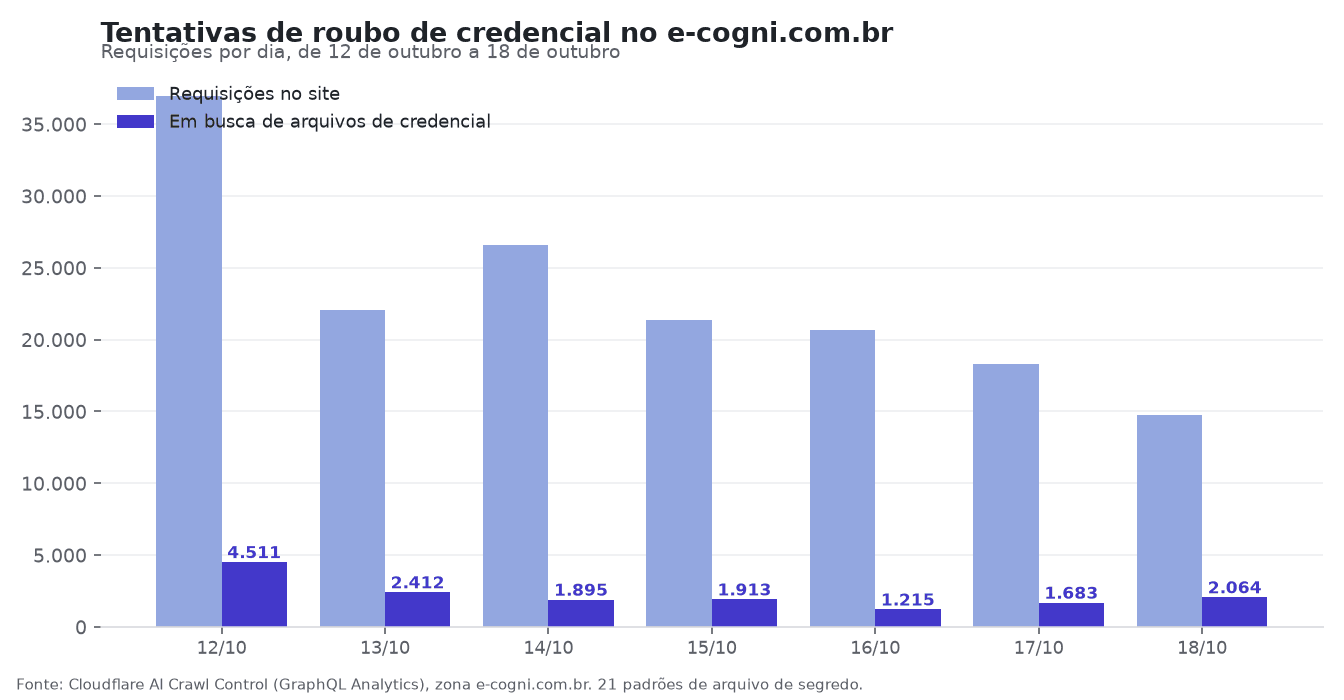
Entre 12 e 18 de outubro de 2026, o domínio recebeu 160.754 requisições, das quais 15.693 miraram caminhos de arquivo de credencial, o equivalente a 9,76% do total. Na semana anterior foram 163.185 requisições e 15.101 tentativas de credencial, então o volume total caiu enquanto a fatia agressiva subiu.
Dessas 15.693 tentativas, 8.413 se apresentaram com nome de crawler conhecido, e nenhuma delas tinha bot verificado pela Cloudflare. O contraste com as 7.563 da semana anterior mostra que o rótulo de robô de IA ficou mais popular entre quem varre o site.
A conclusão é direta: nome de crawler de IA neste domínio é fantasia de scanner. Quem bloqueia ou libera tráfego pela string do user-agent está classificando errado 8.413 requisições por semana, e a verificação da Cloudflare é o único critério que separou robô real de disfarce nesse período.
Quem vestiu o nome de quem
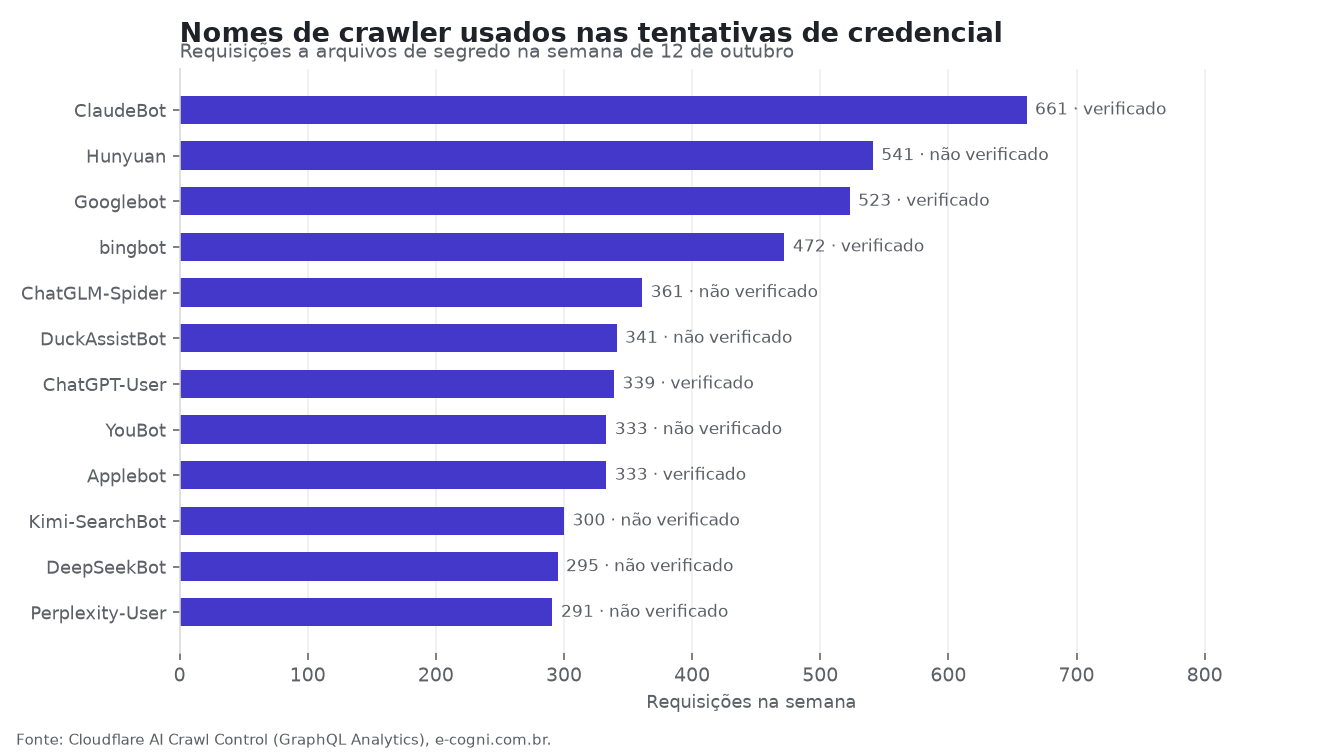
ClaudeBot (661 tentativas), Hunyuan (541), Googlebot (523), bingbot (472), ChatGLM-Spider (361), DuckAssistBot (341), ChatGPT-User (339) e YouBot (333) lideraram as tentativas de credencial na semana passada. Em nenhuma delas a verificação de bot da Cloudflare apareceu.
Os números de requisições verificadas se referem ao site inteiro, não a esses acessos a caminhos de credencial. Nas tentativas de credencial, o total de requisições verificadas na semana foi zero.
Um nome de crawler é apenas um cabeçalho que o cliente escolhe enviar na requisição. Qualquer script pode se declarar ClaudeBot ou Googlebot sem passar por nenhuma checagem, e o servidor que confia nesse rótulo trata o visitante como o robô anunciado.
Os crawlers de IA somaram 15.492 requisições, sendo 6.865 em caminhos de credencial. Os buscadores fizeram 11.724 requisições, 1.548 delas nesses caminhos, e as ferramentas de SEO fizeram 1.521, nenhuma em credencial.
A verificação ausente nas tentativas de credencial indica que o bloqueio por bot não cobre essa rota. Quem administra o site deve tratar o cabeçalho como dado não confiável e aplicar a checagem antes de qualquer decisão de acesso.
De onde vinham
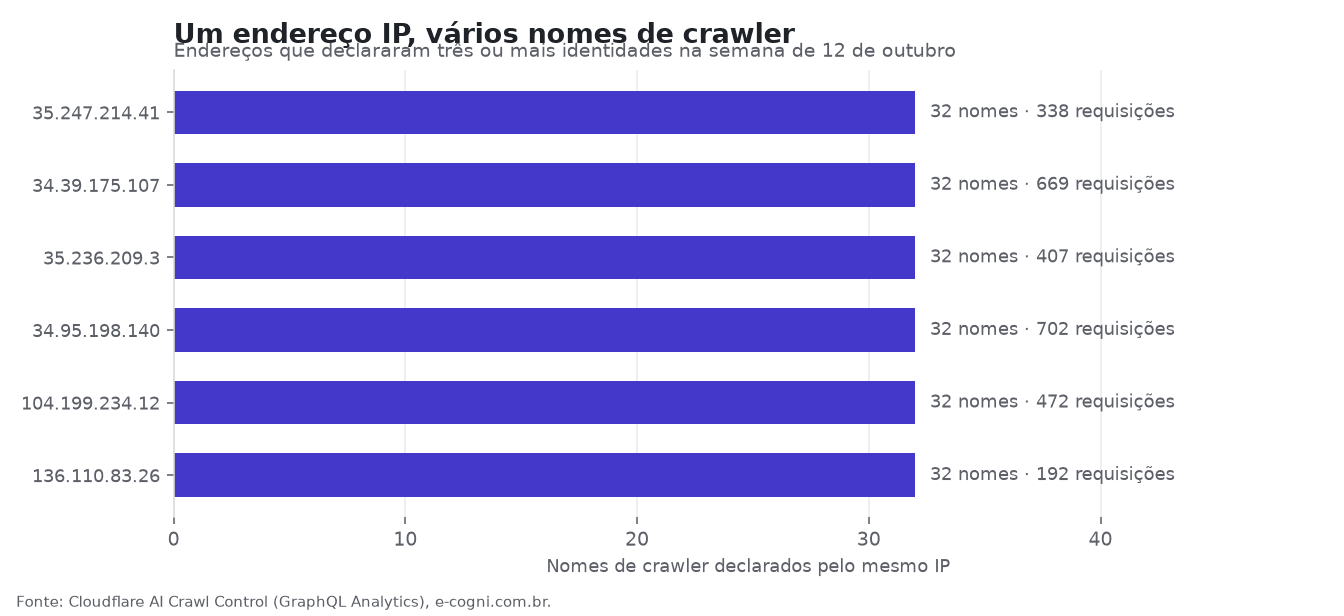
Oito endereços declararam 32 nomes distintos de crawler cada um na semana passada, o que concentra a maior parte dessa confusão de identidade em poucas máquinas. O IP 35.247.214.41, no Brasil, somou 338 requisições com 32 nomes diferentes, e o IP 34.39.175.107, também no Brasil, chegou a 669 requisições com o mesmo número de identidades declaradas.
No Brasil ainda aparecem o IP 34.95.198.140, com 702 requisições e 32 nomes, e o IP 35.236.209.3, nos Estados Unidos, com 407 requisições e 32 nomes.
O IP 104.199.234.12, em Taiwan, fez 472 requisições declarando 32 nomes, enquanto o IP 136.110.83.26, no Japão, registrou 192 requisições com 32 identidades. O IP 104.199.86.11, na Bélgica, alcançou 661 requisições e 32 nomes, e o IP 136.107.227.156, nos Estados Unidos, fechou com 338 requisições e 32 nomes declarados.
Cada um desses endereços trocou de identidade dezenas de vezes dentro da mesma faixa de requisições.
Esse padrão prova que rastreadores de empresas diferentes operam de faixas próprias e não compartilham endereço. Quando um único IP se apresenta como 32 crawlers distintos, o que existe é mascaramento de origem, não colaboração entre operadores.
Para quem administra site, bloquear por nome de agente ou por user-agent deixa de funcionar nesses casos, porque o mesmo endereço assume qualquer rótulo que lhe convenha.
O que eles procuravam
A busca por arquivos de ambiente domina a atividade: o padrão env somou 11.432 requisições, contra 975 de credential e 628 de env_encoded. Os robôs procuram chaves de API, senhas de banco e tokens de serviço em arquivos que quase nunca deveriam estar públicos.
O caminho www.e-cogni.com.br/.env recebeu 289 pedidos, seguido por www.e-cogni.com.br/@fs/root/.env com 264 e www.e-cogni.com.br/.env.local com 147. As variantes .env.stage, .env.production e API/.env completam a lista, junto de phpinfo (556), git (438), secret (419), backup (368), docker_compose (344), aws (314) e ssh (250).
A exploração de leitura de arquivo do Vite, via /@fs/ e CVE-2025-30208, respondeu por 1.246 requisições. A descoberta de contêiner por /proc/self teve 462 tentativas, e o editor de código exposto em /icecoder somou 109.
O site é estático, gerado com Gatsby no Cloudflare Pages, e nenhum desses arquivos existe no servidor.
O que fazer com isso
Validar o endereço de origem contra a faixa publicada pelo fornecedor resolve a maior parte da confusão criada pelo nome declarado no cabeçalho. O nome do robô é declaração do cliente e não prova de identidade, então a decisão precisa sair do IP e da faixa oficial, não do texto que chegou na requisição.
Pedido a arquivo de segredo deve ser tratado como alarme, com registro e revisão do que estava exposto naquele caminho. Nunca deixe .env, .git ou dump de banco em diretório público, porque esses são exatamente os alvos que os scanners testam em sequência.
Corrija o que os scanners procuram antes de discutir bloqueio: versão desatualizada, painel aberto, backup acessível e credencial padrão. As tentativas de credencial registradas não tinham, na prática, verificação de bot, o que reforça a escolha por robô verificado em vez de nome declarado.
Como medimos
Os dados vêm da API GraphQL Analytics da Cloudflare, no conjunto httpRequestsAdaptiveGroups, o mesmo que alimenta o painel AI Crawl Control. A semana vai de 12 de outubro a 18 de outubro e a coleta é feita dia a dia, porque a API aceita janelas de 24 horas por consulta e a zona gratuita guarda 31 dias de histórico.
Classificamos como caminho de credencial 21 padrões de arquivo de segredo, de .env e .aws/credentials a chave privada, dump de banco e cofre de senha. Só requisições de cliente real, cada uma contada uma vez.
Duas ressalvas. A categoria de bot verificado da Cloudflare não cobre todos os crawlers que existem, então a ausência dela não condena um nome sozinho: o que condena é o conjunto, com o mesmo endereço assinando dezenas de nomes e uma lista de arquivos que só interessa a quem quer senha.
E user-agent, por definição, é o que o cliente escolhe dizer.
Os gráficos são feitos pelo E-Cogni com os dados brutos da coleta.


