

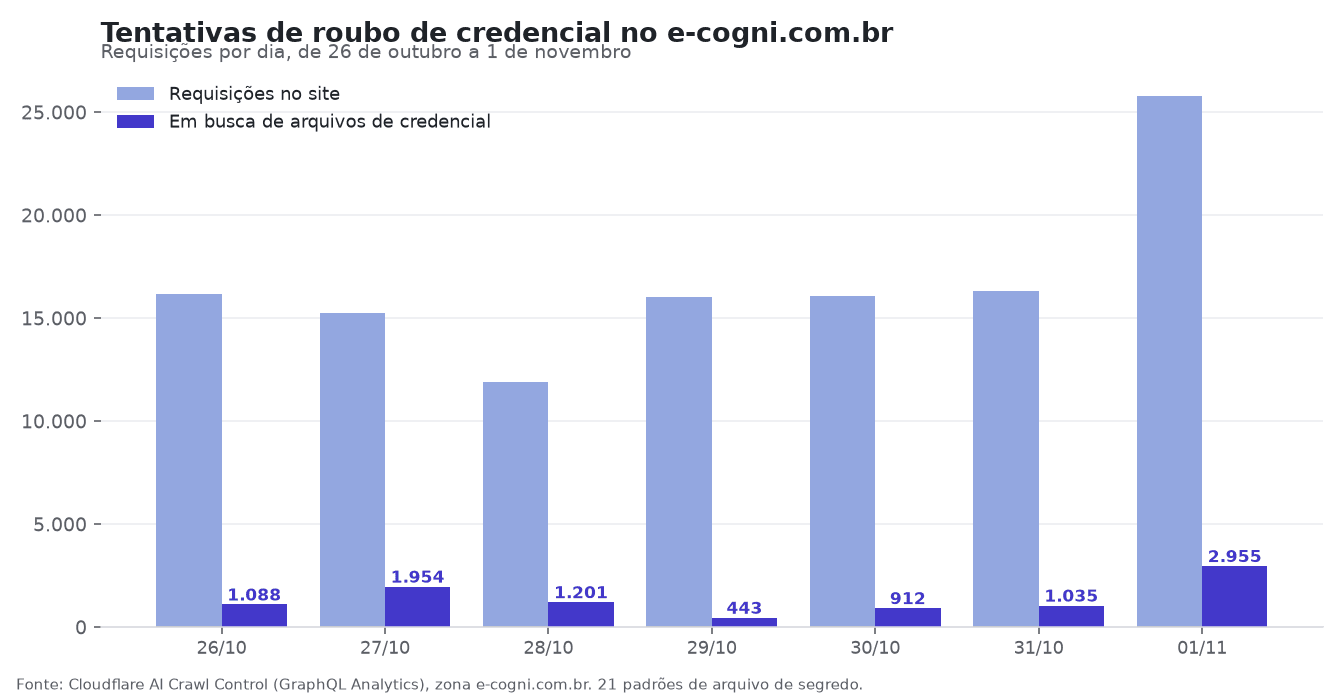
Na semana de 26 de outubro a 1 de novembro de 2026, o domínio do E-Cogni recebeu 117.456 requisições. Caminhos típicos de arquivos de credenciais foram acessados 9.588 vezes, o que representou 8,16% do total; esse volume indica pressão persistente de scanners.
Entre essas tentativas, 2.304 requisições usaram nomes de crawlers de inteligência artificial populares, porém nenhuma delas correspondeu a bots reconhecidos pela Cloudflare.
No período anterior, o volume total foi de 123.532 requisições, com 13.666 tentativas de acesso a arquivos de credencial e 2.909 ocorrências de nomes de crawler conhecidos. Houve uma leve queda no número de requisições totais e de ataques direcionados, mas a proporção das tentativas de credencial permanece significativa.
O padrão confirma que nomes de crawlers de IA são, na prática, apenas fachada para scanners automatizados tentando obter acesso não autorizado. Não há correspondência entre a alegação do User-Agent e a presença de bots verificados.
Quem vestiu o nome de quem
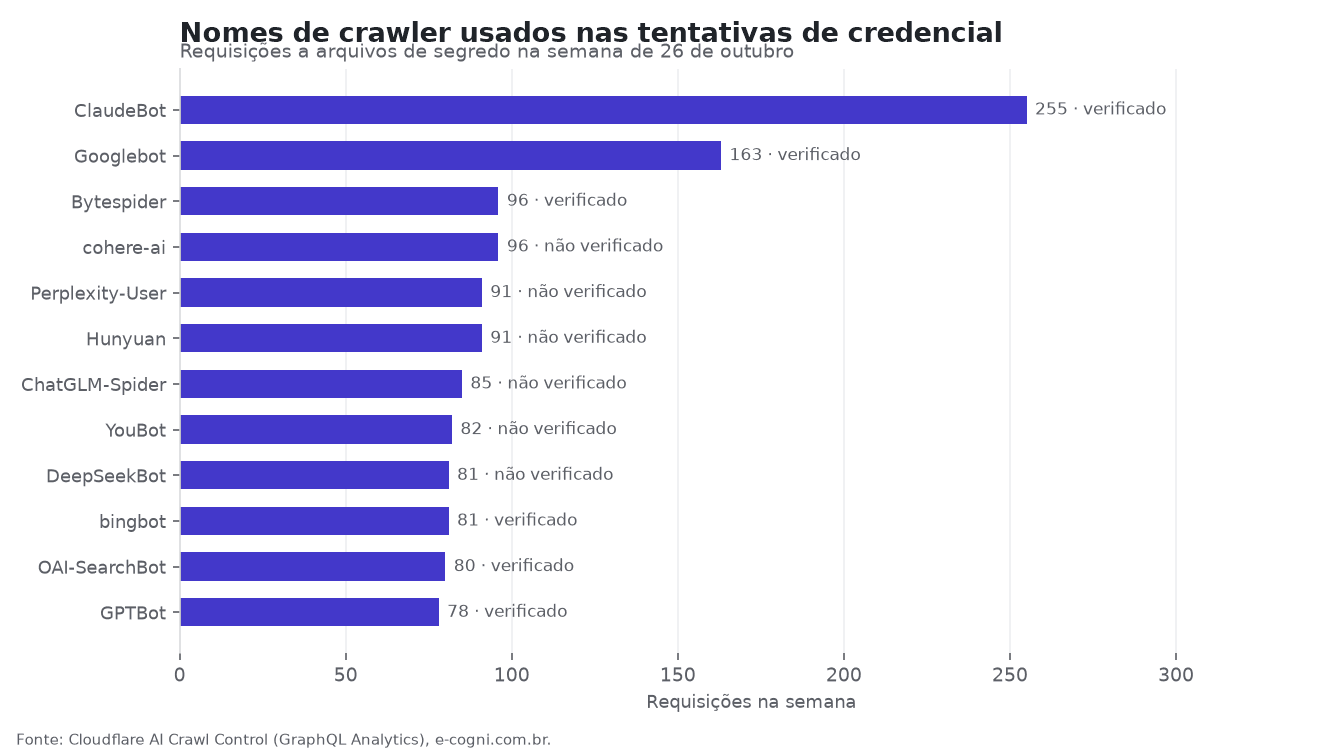
Os logs mostram um padrão claro de tentativas de acesso a caminhos de credencial usando nomes de crawlers conhecidos. Os nomes mais usados nessas ações foram ClaudeBot, Googlebot, Bytespider, cohere-ai, Perplexity-User, Hunyuan, ChatGLM-Spider e YouBot.
ClaudeBot liderou em tentativas, com 255 requisições em caminhos de credencial. Googlebot veio em seguida, com 163, e Bytespider teve 96.
O grupo cohere-ai também apareceu 96 vezes, Perplexity-User e Hunyuan empataram em 91 cada, seguidos de perto por ChatGLM-Spider (85) e YouBot (82).
É importante notar que, nas tentativas de credencial, nenhuma requisição passou pela verificação de bot da Cloudflare. Em outras palavras, todas essas ações foram feitas fora do radar do mecanismo padrão de validação de automação.
Isso sugere que o uso desses nomes de crawler não está associado à operação legítima dos robôs que representam, mas sim à tentativa de mascarar acessos manuais ou automatizados.
O nome do robô, nesse contexto, é apenas um cabeçalho HTTP que o cliente escolhe enviar — não há garantia de que o agente identificado realmente pertence à entidade que diz ser. A escolha desses nomes visa enganar filtros automatizados e dificultar a distinção entre tráfego legítimo e tentativas de exploração.
Das 1.931 requisições a caminhos de credencial feitas por supostos crawlers de IA, todas traziam nomes conhecidos e nenhuma delas foi interceptada pela verificação automatizada da Cloudflare. Esse padrão reforça a necessidade de não confiar unicamente no campo de identificação do agente ao monitorar e bloquear acessos suspeitos.
De onde vinham
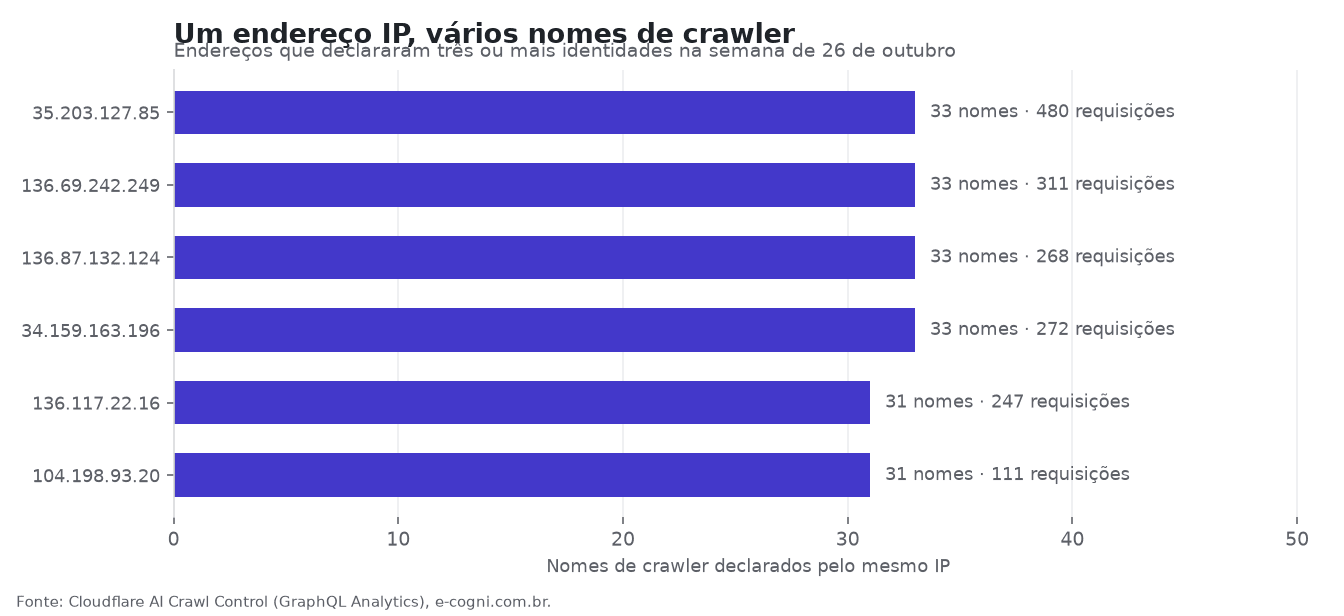
O endereço 35.203.127.85, no Canadá, declarou 33 nomes diferentes de crawler e realizou 480 requisições. O IP 34.95.13.186, também no Canadá, usou 30 nomes e fez 326 requisições.
Não há sobreposição de endereços entre os dois, sugerindo operações independentes.
Nos Estados Unidos, quatro IPs se destacaram pela variedade de nomes declarados. O 136.69.242.249 declarou 33 nomes e fez 311 requisições; já o 136.87.132.124 declarou 33 nomes e efetuou 268 acessos.
O 136.117.22.16 usou 31 nomes distintos, com 247 requisições. O 136.108.254.34 declarou 30 nomes e registrou 196 acessos.
Nenhum desses endereços apareceu em outros países, e tampouco compartilharam IP com empresas diferentes, cada um opera isolado.
No Japão, o IP 104.198.93.20 declarou 31 nomes e realizou 111 requisições. Já na Alemanha, o 34.159.163.196 declarou 33 nomes e fez 272 requisições.
Esses endereços não coincidem com outros países e não repetem IPs das faixas anteriores. Cada empresa mantém sua infraestrutura separada para os rastreadores, sem compartilhamento entre domínios diferentes.
O que eles procuravam
Robôs e scanners direcionaram a maior parte das tentativas para arquivos sensíveis, com destaque para padrões como .env (6.245 requisições), credential (652) e .git (597), além de scripts como phpinfo (570) e arquivos de backup (320). Houve também interesse em arquivos secret (317), config_json (260), chaves aws (236), dumps sql (229) e wp_config (196), indicando busca por credenciais e configurações expostas.
Os caminhos mais insistentes miravam www.e-cogni.com.br/.git/config (98 vezes) e www.e-cogni.com.br/.env (83), seguidos de e-cogni.com.br/.git/config (65), cdn-app-s.e-cogni.com.br/.env (33) e e-cogni.com.br/.env (31). Também houve tentativas para variantes como .env.swp, .env.production e .env.local em múltiplos subdomínios, sempre mirando possíveis leaks de configuração.
Além da enumeração de arquivos, detectamos 146 acessos para descoberta de contêiner via /proc/self e 78 tentativas de exploração do bug de leitura de arquivo no Vite (CVE-2025-30208) usando o caminho /@fs/. Nenhuma dessas tentativas teve êxito, o ambiente estático do Gatsby no Cloudflare Pages não expõe esses arquivos.
O que fazer com isso
Robôs declarados como Googlebot e Bingbot acessaram o domínio, mas só havia correspondência de nome, sem checagem real do endereço IP de origem. Isso permite que qualquer cliente se anuncie como agente de busca conhecido e obtenha tratamento diferenciado, mesmo não sendo legítimo.
Foram registradas tentativas de acesso a arquivos sensíveis como .env e .git, sempre por scanners automatizados. Nenhuma requisição desse tipo passou por mecanismo de verificação específico para bots.
Implemente validação do IP de origem para todos os acessos declarados como agentes de busca, conferindo com as faixas oficiais dos fornecedores. Nunca trate só o nome do agente como suficiente para liberar privilégios ou ignorar controles de acesso.
Configure o servidor para negar qualquer pedido a arquivos como .env, .git e dumps de banco de dados, independentemente de quem solicita. Trate qualquer tentativa de leitura desses arquivos como alarme, pois indica varredura automatizada.
Revise periodicamente o site e corrija todas as vulnerabilidades que scanners estão caçando. Ao decidir liberar acesso avançado para robôs, baseie-se sempre em validação de IP e reputação, não no nome declarado pelo cliente.
Como medimos
Os dados vêm da API GraphQL Analytics da Cloudflare, no conjunto httpRequestsAdaptiveGroups, o mesmo que alimenta o painel AI Crawl Control. A semana vai de 26 de outubro a 1 de novembro e a coleta é feita dia a dia, porque a API aceita janelas de 24 horas por consulta e a zona gratuita guarda 31 dias de histórico.
Classificamos como caminho de credencial 21 padrões de arquivo de segredo, de .env e .aws/credentials a chave privada, dump de banco e cofre de senha. Só requisições de cliente real, cada uma contada uma vez.
Duas ressalvas. A categoria de bot verificado da Cloudflare não cobre todos os crawlers que existem, então a ausência dela não condena um nome sozinho: o que condena é o conjunto, com o mesmo endereço assinando dezenas de nomes e uma lista de arquivos que só interessa a quem quer senha.
E user-agent, por definição, é o que o cliente escolhe dizer.
Os gráficos são feitos pelo E-Cogni com os dados brutos da coleta.


