

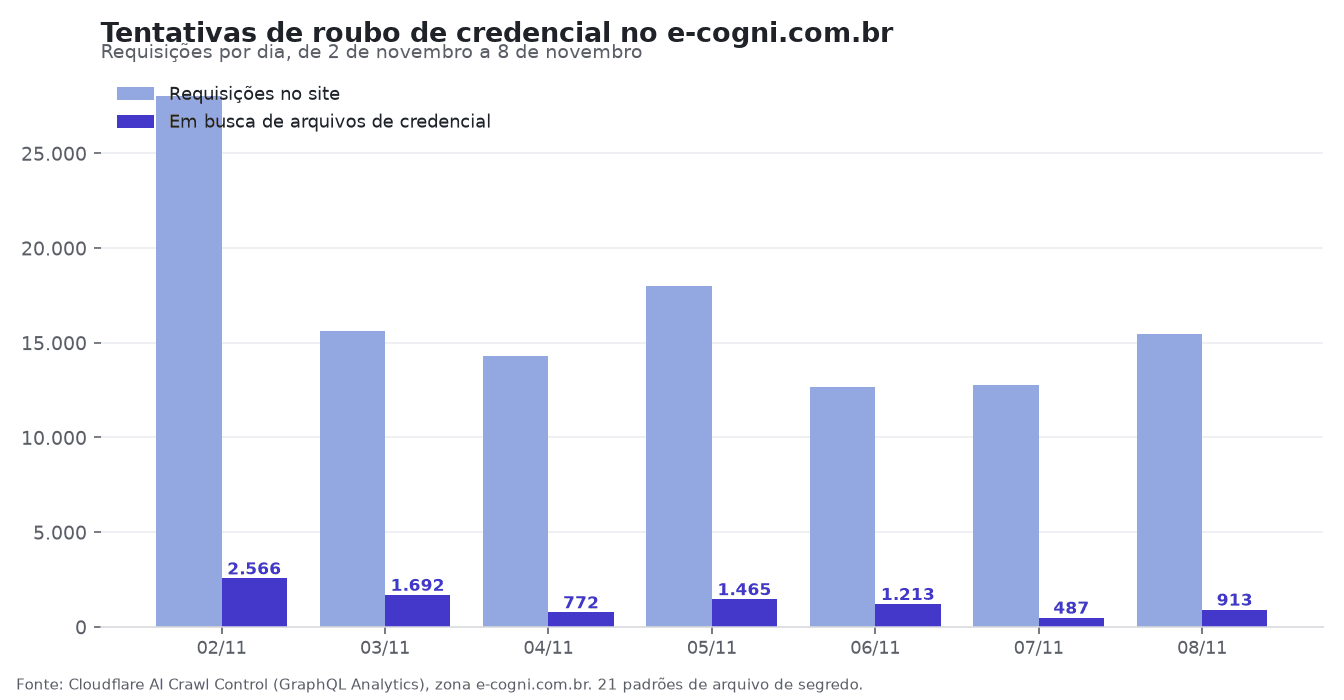
Entre 2 e 8 de novembro de 2026, o domínio do E-Cogni registrou 116.780 requisições totais. Destas, 9.108 tentaram acessar caminhos de arquivo de credencial, o que representa 7,8% do tráfego semanal.
O padrão repete o volume observado na semana anterior, quando houve 9.588 tentativas desse tipo.
No recorte atual, 3.076 tentativas de credencial usaram nomes de crawlers conhecidos como agente de usuário, mas nenhuma delas partiu de bot verificado pela Cloudflare. A elevação desse uso em relação à semana anterior — 2.304 casos, mostra que essa tática se espalhou entre scanners automatizados.
A conclusão fica clara: nomes de crawlers de inteligência artificial são fantasia adotada por scanners em busca de arquivos sensíveis. Não há relação com bots legítimos.
Quem vestiu o nome de quem
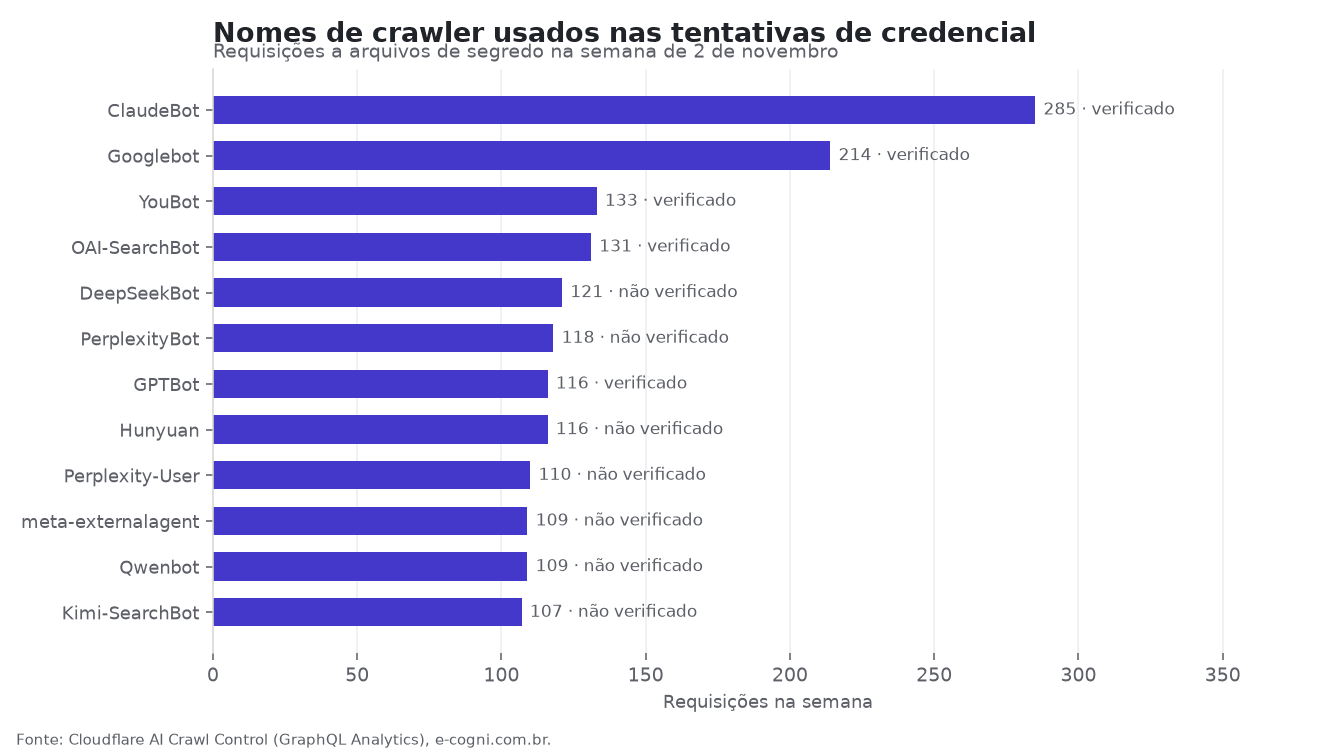
Na semana passada, oito nomes de crawlers apareceram em tentativas de acesso a caminhos de credencial no E-Cogni. ClaudeBot liderou em tentativas, com 285 acessos, seguido pelo Googlebot, com 214, e pelo YouBot, com 133.
OAI-SearchBot (131), DeepSeekBot (121), PerplexityBot (118), GPTBot (116) e Hunyuan (116) também tentaram acessar rotas de login ou administrativas.
Nenhuma dessas tentativas de credencial foi marcada como verificada pela Cloudflare. Ou seja, não houve passagem pelo desafio ou teste de bot da Cloudflare em nenhum desses acessos.
A verificação com a Cloudflare apareceu somente em outras rotas do site, como mostram os números totais de requisições dos bots, mas nunca nos caminhos de credencial.
O cabeçalho de identificação – o chamado nome do robô, como "Googlebot" ou "ClaudeBot" – é totalmente controlado pelo cliente que faz a requisição. O servidor recebe o nome que o agente remoto quiser declarar, e não há garantia de que a origem tenha relação real com o serviço alegado.
O uso de nomes de bots conhecidos em tentativas de login sugere camuflagem ou script malicioso, já que buscadores legítimos não acessam esse tipo de rota.
Entre os grupos de bots que acessaram o E-Cogni, crawlers de IA geraram 2.566 acessos a caminhos de credenciais, enquanto buscadores tradicionais fizeram 510 e ferramentas de SEO não tentaram esses acessos. A proporção mostra que o uso de nomes de bots de IA em tentativas de acesso privilegiado está se consolidando como padrão entre automações não autorizadas.
O dado mais relevante: tentativas de credencial continuam sem passar por verificação ativa de bot, reforçando a utilidade de barreiras adicionais nas rotas sensíveis.
De onde vinham
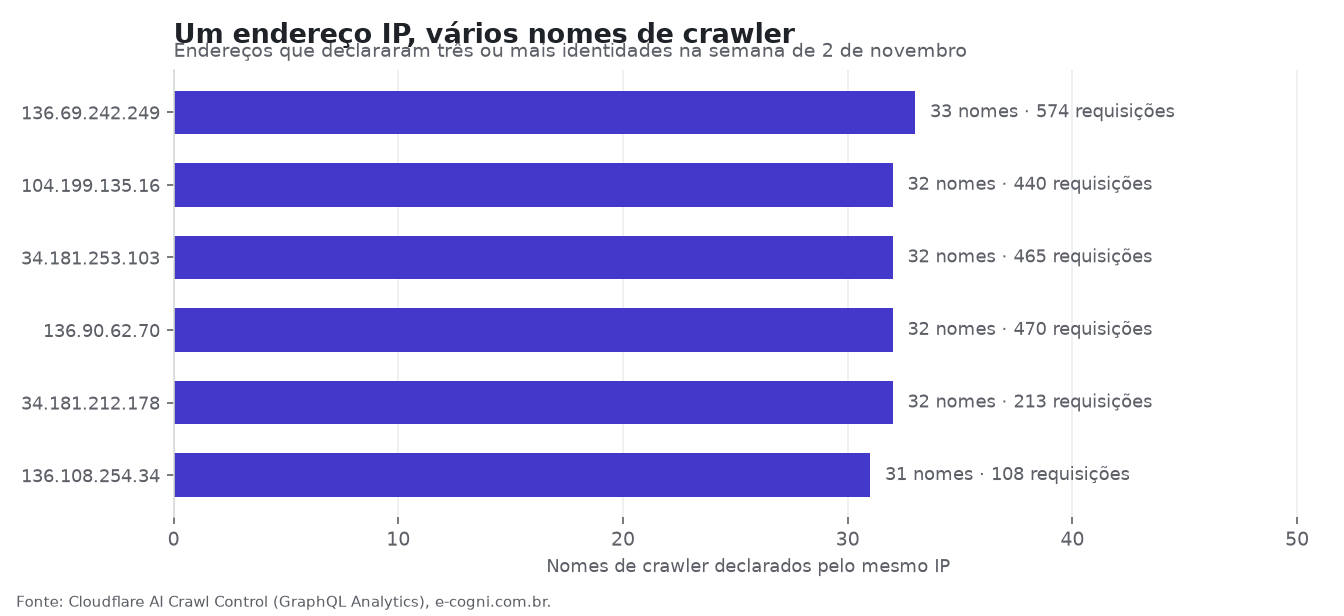
Entre todos os acessos identificados, oito endereços IP chamaram atenção por declararem três ou mais nomes diferentes de rastreadores na mesma semana. O IP 136.69.242.249, localizado nos Estados Unidos, apresentou o maior número: declarou 33 nomes distintos de crawler e realizou 574 requisições ao domínio.
Outros IPs relevantes, como 104.199.135.16, em Taiwan, e 34.181.253.103, também nos Estados Unidos, declararam 32 nomes diferentes, com 440 e 465 requisições respectivamente.
O padrão se repete em mais cinco endereços, todos com mais de 30 nomes de rastreador declarados. O IP 136.90.62.70, dos Estados Unidos, realizou 470 requisições e declarou 32 nomes diferentes.
34.181.212.178, também nos Estados Unidos, fez 213 requisições e declarou 32 nomes. Já o 136.108.254.34, ainda nos Estados Unidos, declarou 31 nomes e realizou 108 requisições.
Na Alemanha, o IP 34.179.250.225 apresentou 31 nomes distintos em 176 requisições. O IP 136.71.206.95, dos Estados Unidos, também declarou 31 nomes e registrou 361 requisições.
O fato de um mesmo endereço IP declarar dezenas de nomes diferentes mostra que rastreadores de empresas separadas não usam a mesma faixa de IP nem compartilham infraestrutura de acesso. Isso permite distinguir operações automatizadas por endereço, mesmo quando tentam mascarar a identidade por meio de nomes variados.
O que eles procuravam
Os robôs priorizaram buscas por arquivos sensíveis, principalmente variações de .env, que somaram 6.230 acessos em uma semana. Além deles, tentaram acessar arquivos de credenciais (514), phpinfo (508), versões codificadas de env (460), repositórios git (295) e arquivos de configuração de WordPress e AWS.
Também apareceram buscas por arquivos de backup e JSON de configuração.
Os caminhos mais solicitados mostram tentativas sistemáticas de varredura nos locais padrão de aplicações web. O arquivo mais visado foi www.e-cogni.com.br/.env, com 66 acessos, seguido por outras variantes do mesmo arquivo e diretórios relacionados, como .env.local, .env.backup e src/.env. Também houve tentativas de acessar arquivos de credenciais do Google (Google-credentials.json) e configurações do Git (.git/config), além de buscar backups de wp-config.php.
Foram registradas 192 tentativas de acessar /proc/self, sinalizando busca por evidências de contêiner ou ambiente virtualizado. Nenhum desses arquivos existe no servidor, já que a aplicação é estática e não utiliza backend exposto.
O padrão de resposta HTTP reflete isso: 50.075 retornos 200, 32.055 redirecionamentos (301) e 23.304 erros 404.
O que fazer com isso
Nomes de robôs em headers HTTP são autodeclarados pelos clientes e não têm garantia de autenticidade, o que reduz sua utilidade direta como critério de bloqueio ou priorização. Não houve verificação sistemática de bot nas tentativas de credencial, abrindo espaço para automação não detectada ao longo da semana.
Valide todo endereço de origem de acesso automatizado contra a faixa de IPs publicada oficialmente pelo fornecedor do robô. Não confie apenas no nome declarado ou no user-agent, pois é trivial para atacantes falsificarem essas informações.
Trate como alarme qualquer tentativa de acesso a arquivos sensíveis, como .env, .git ou dumps de banco de dados – mesmo que não haja conteúdo exposto. Impeça a exposição desses arquivos em diretórios públicos, configurando o servidor para negar acesso e removendo eventuais arquivos esquecidos.
Corrija imediatamente configurações ou endpoints que venham sendo procurados insistentemente por scanners conhecidos, mesmo que aparentemente estejam protegidos. Só mantenha robôs de acesso verificado, decidindo por validação ativa e não por nomenclatura informada no tráfego.
Como medimos
Os dados vêm da API GraphQL Analytics da Cloudflare, no conjunto httpRequestsAdaptiveGroups, o mesmo que alimenta o painel AI Crawl Control. A semana vai de 2 de novembro a 8 de novembro e a coleta é feita dia a dia, porque a API aceita janelas de 24 horas por consulta e a zona gratuita guarda 31 dias de histórico.
Classificamos como caminho de credencial 21 padrões de arquivo de segredo, de .env e .aws/credentials a chave privada, dump de banco e cofre de senha. Só requisições de cliente real, cada uma contada uma vez.
Duas ressalvas. A categoria de bot verificado da Cloudflare não cobre todos os crawlers que existem, então a ausência dela não condena um nome sozinho: o que condena é o conjunto, com o mesmo endereço assinando dezenas de nomes e uma lista de arquivos que só interessa a quem quer senha.
E user-agent, por definição, é o que o cliente escolhe dizer.
Os gráficos são feitos pelo E-Cogni com os dados brutos da coleta.


