

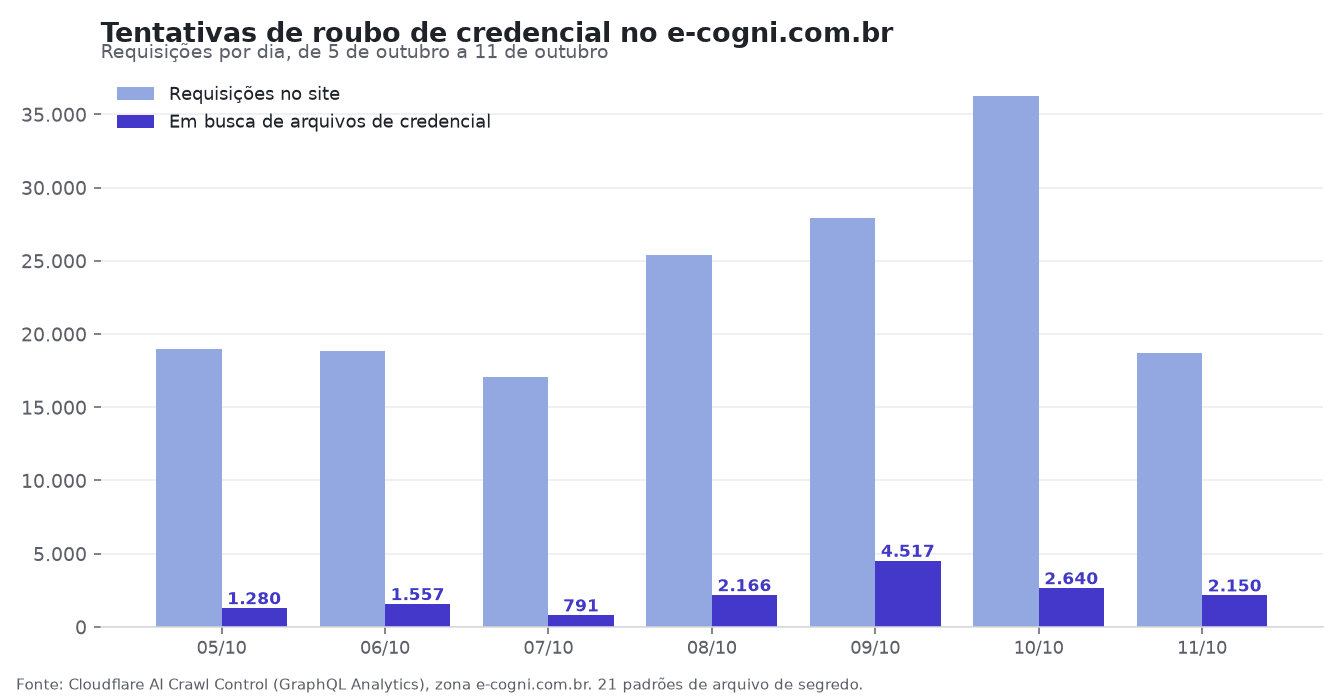
Entre 5 e 11 de outubro de 2026, o domínio registrou 163.185 requisições, das quais 15.101 tentaram alcançar caminhos de arquivo de credencial, o equivalente a 9,25% do tráfego. Na semana anterior, essas tentativas somaram 19.115 de 153.457 requisições, ou 12,46%.
O volume absoluto de sondagens caiu, mas a proporção de scanners que se disfarçam cresceu. Das 15.101 tentativas de credencial, 7.563 se apresentaram com nome de crawler conhecido, contra 6.956 na semana anterior.
Apenas 19 dessas requisições tinham bot verificado pela Cloudflare.
O dado fecha a conclusão da semana: nome de crawler de inteligência artificial virou fantasia barata em scanner de credencial. Quem filtra por user agent e libera o resto entrega os caminhos sensíveis a qualquer script que copie uma string conhecida.
Quem vestiu o nome de quem
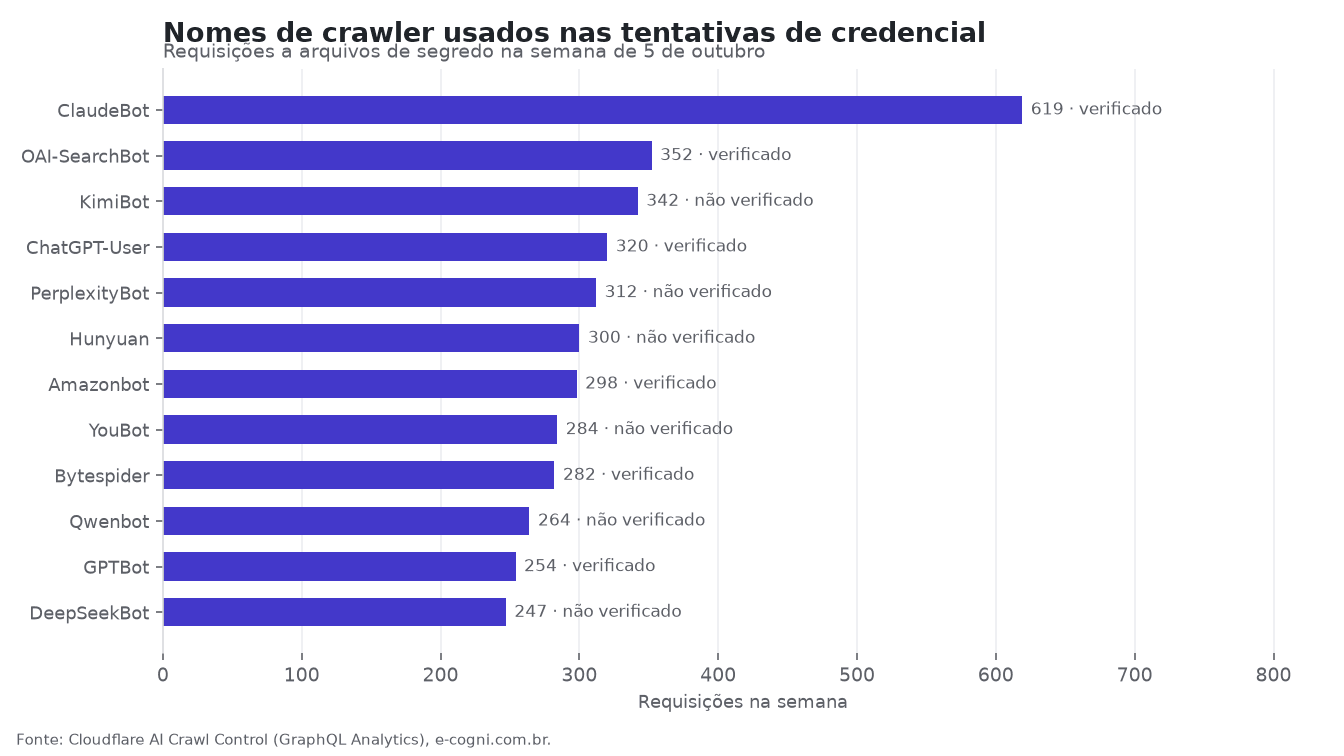
ClaudeBot, OAI-SearchBot, KimiBot, ChatGPT-User, PerplexityBot, Hunyuan, Amazonbot e YouBot foram os nomes escolhidos nas tentativas de credencial da semana passada. ClaudeBot somou 619 tentativas, OAI-SearchBot 352, KimiBot 342, ChatGPT-User 320, PerplexityBot 312, Hunyuan 300, Amazonbot 298 e YouBot 284.
Nas tentativas de credencial, o total de requisições com verificação de bot da Cloudflare foi 19 na semana. Esse número não se distribui de forma proporcional entre os nomes citados, e a verificação não apareceu como barreira relevante nesse conjunto específico de acessos.
Os totais de verificação por nome, como 799 em ClaudeBot ou 2.353 em OAI-SearchBot, referem-se ao site inteiro, não a esses caminhos.
Um nome de crawler é apenas um cabeçalho que o cliente escolhe enviar na requisição. Não há validação embutida no protocolo, e qualquer script pode se declarar ClaudeBot ou PerplexityBot sem passar por checagem alguma.
Bloquear por nome de agente não separa o robô legítimo da tentativa de credencial que copiou o rótulo.
Os crawlers de IA fizeram 19.893 requisições no site, sendo 6.737 em caminhos de credencial. Buscadores somaram 8.522 requisições, com 826 nesses caminhos, e ferramentas de SEO registraram 2.078 requisições, nenhuma delas em caminhos de credencial.
De onde vinham
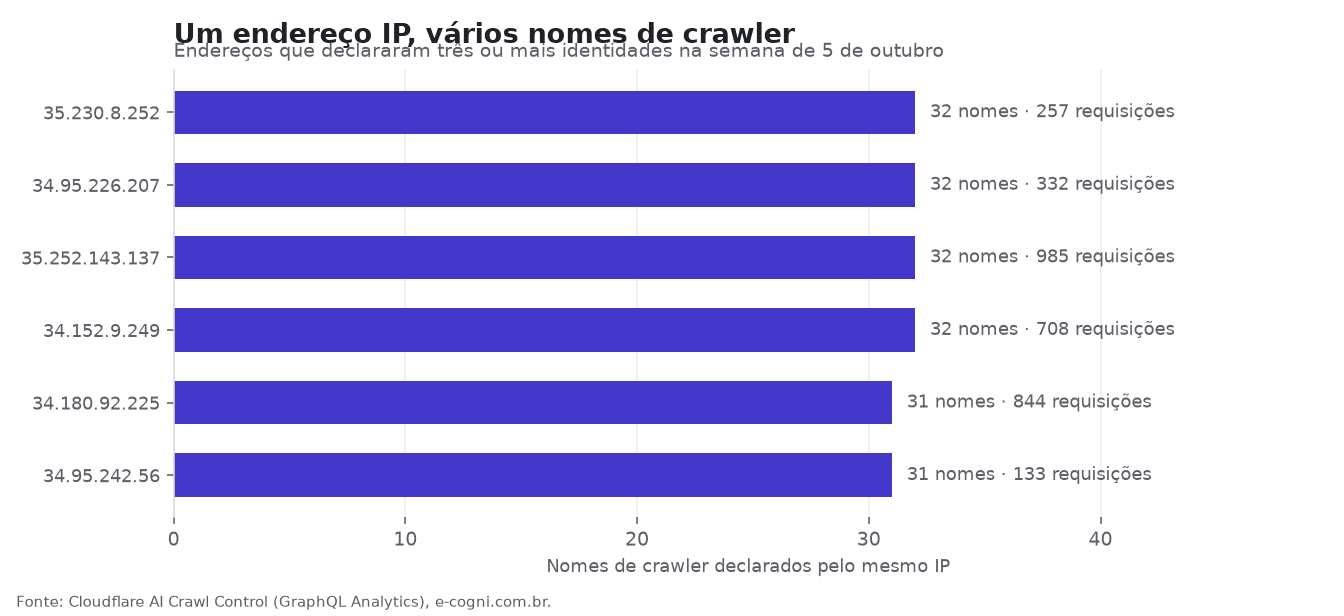
Na semana passada, oito endereços declararam três ou mais nomes de crawler diferentes ao bater no domínio. O IP 35.252.143.137, nos Estados Unidos, apresentou 32 nomes distintos em 985 requisições.
O IP 34.180.92.225, no Japão, somou 31 nomes em 844 requisições.
O IP 34.152.9.249, no Canadá, registrou 32 nomes e 708 requisições. O IP 34.95.226.207, no Brasil, também listou 32 nomes, com 332 requisições.
O IP 35.230.8.252, nos Estados Unidos, trouxe 32 nomes em 257 requisições. O IP 34.118.157.20, no Canadá, declarou 29 nomes e 218 requisições.
O IP 34.185.218.198, na Alemanha, apresentou 30 nomes em 172 requisições. O IP 34.95.242.56, no Brasil, fechou com 31 nomes e 133 requisições.
Esse padrão mostra que rastreadores de empresas distintas operam de faixas próprias e não compartilham endereço.
O que eles procuravam
Os robôs caçaram arquivos de configuração e credenciais acima de tudo. O padrão env somou 8.076 requisições, seguido por env_encoded com 2.638 e credential com 1.013.
Secret apareceu 597 vezes, phpinfo 525, aws 518, config_json 466, backup 394, git 388 e ssh 386.
Os caminhos exatos repetem o mesmo alvo em variações de subdomínio e sufixo. www.e-cogni.com.br/.env recebeu 366 pedidos, e-cogni.com.br/.env ficou com 209 e www.e-cogni.com.br/config.json com 140. As versões .env.local somaram 125 e 114, enquanto .env.production marcou 99 e 76.
A exploração de leitura de arquivo do Vite, via /@fs/ e CVE-2025-30208, concentrou 2.058 requisições. A descoberta de contêiner por /proc/self chegou a 514 tentativas, e o editor exposto /icecoder somou 42.
Como o site é estático, gerado em Gatsby e hospedado no Cloudflare Pages, nenhum desses arquivos existe no servidor.
O que fazer com isso
Validar o endereço de origem contra a faixa publicada pelo fornecedor separa tráfego legítimo de imitação barata, porque o nome declarado no cabeçalho é apenas uma string enviada pelo cliente. Um robô que se apresenta como buscador conhecido sem pertencer à faixa oficial não merece confiança operacional.
Pedido a arquivo de segredo funciona como alarme, não como ruído de fundo. .env, .git e dump de banco expostos em diretório público entregam credencial e estrutura interna a qualquer scanner que passe. Corrigir o que os scanners procuram reduz a superfície antes que a tentativa de credencial encontre algo útil.
As tentativas de credencial registradas não tinham, na prática, verificação de bot. Decida por robô verificado, não por nome declarado.
Como medimos
Os dados vêm da API GraphQL Analytics da Cloudflare, no conjunto httpRequestsAdaptiveGroups, o mesmo que alimenta o painel AI Crawl Control. A semana vai de 5 de outubro a 11 de outubro e a coleta é feita dia a dia, porque a API aceita janelas de 24 horas por consulta e a zona gratuita guarda 31 dias de histórico.
Classificamos como caminho de credencial 21 padrões de arquivo de segredo, de .env e .aws/credentials a chave privada, dump de banco e cofre de senha. Só requisições de cliente real, cada uma contada uma vez.
Duas ressalvas. A categoria de bot verificado da Cloudflare não cobre todos os crawlers que existem, então a ausência dela não condena um nome sozinho: o que condena é o conjunto, com o mesmo endereço assinando dezenas de nomes e uma lista de arquivos que só interessa a quem quer senha.
E user-agent, por definição, é o que o cliente escolhe dizer.
Os gráficos são feitos pelo E-Cogni com os dados brutos da coleta.


