

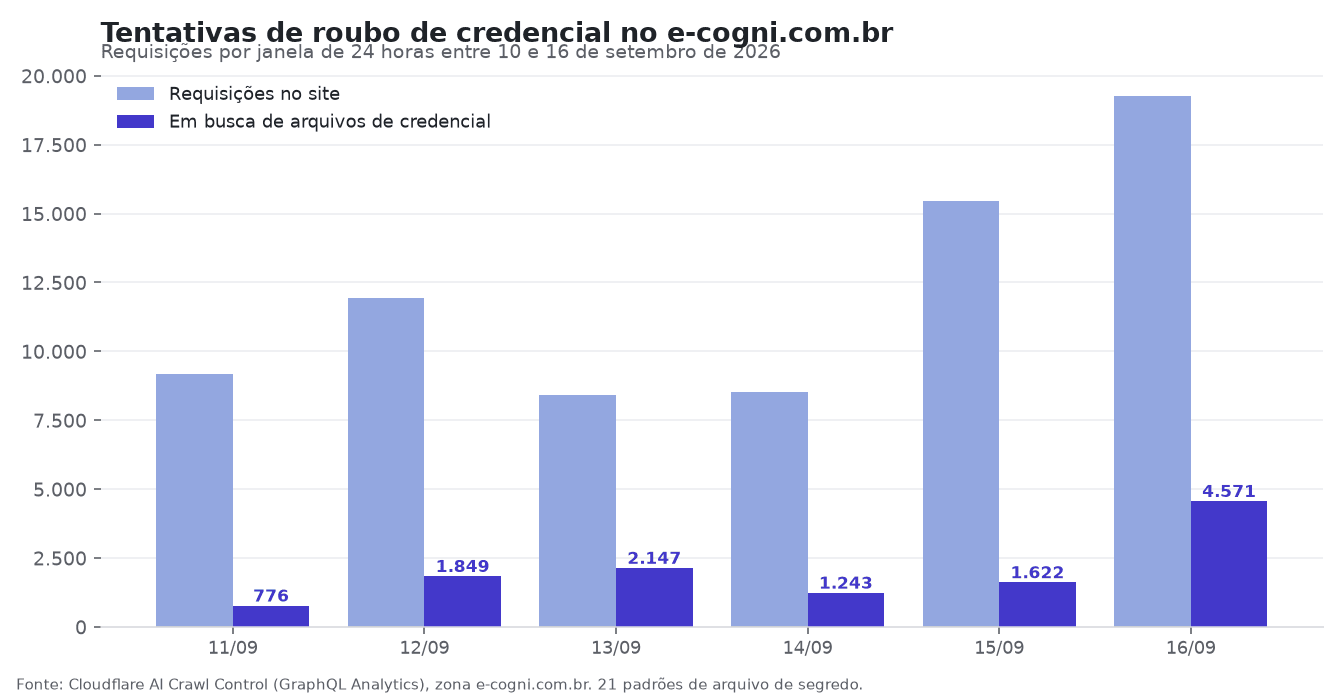
Quase um quarto de tudo o que chegou ao e-cogni.com.br em 24 horas não queria ler página nenhuma: eram pedidos de arquivo de senha.
Entre as 14h30 de 15 de setembro e as 14h30 de 16 de setembro, o site recebeu 19.275 requisições. Dessas, 4.571 pediam arquivos que existem justamente para não serem públicos, como .env, .aws/credentials, .git/config, chave privada e dump de banco.
É 23,7% de tudo o que bateu na nossa borda, quase o triplo do dia anterior.
O número saiu do AI Crawl Control, o painel da Cloudflare que mostra como os crawlers de inteligência artificial tratam um domínio. Só que quem pediu os arquivos de senha não era crawler de IA, e essa é a parte que interessa.
632 nomes de IA, nenhum verificável
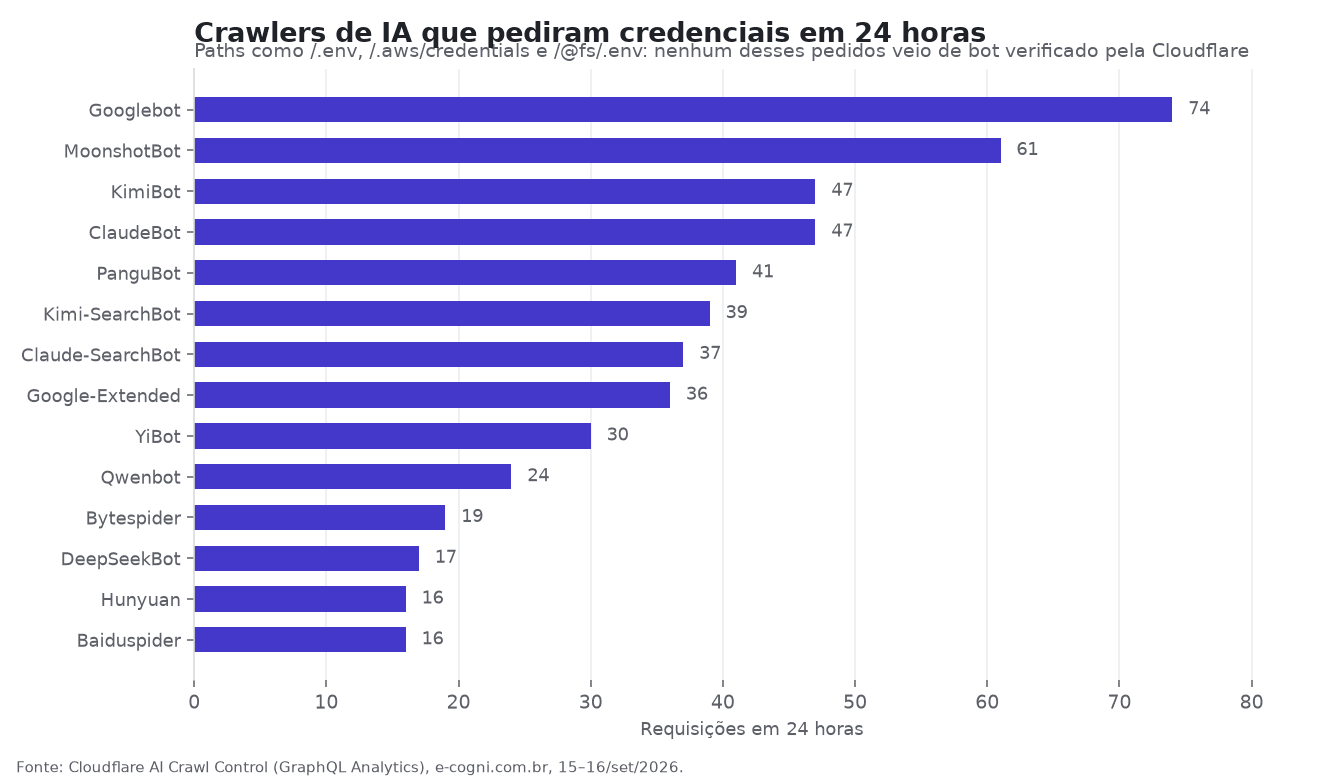
Dos 4.571 pedidos a caminhos de credencial, 632 se apresentaram ao servidor com o nome de um crawler conhecido, entre eles GPTBot, ClaudeBot, Googlebot, PerplexityBot, Bytespider, KimiBot, MoonshotBot, PanguBot, Qwenbot, YiBot, DeepSeekBot e ChatGLM-Spider.
Nenhum desses 632 passou pela verificação de bot da Cloudflare. Nos caminhos normais do site, o ClaudeBot legítimo aparece verificado em 26 das 103 requisições que faz, e o Googlebot em 51 de 190.
Nos caminhos de credencial, a marca de bot verificado não aparece uma única vez.
Um endereço, 24 identidades
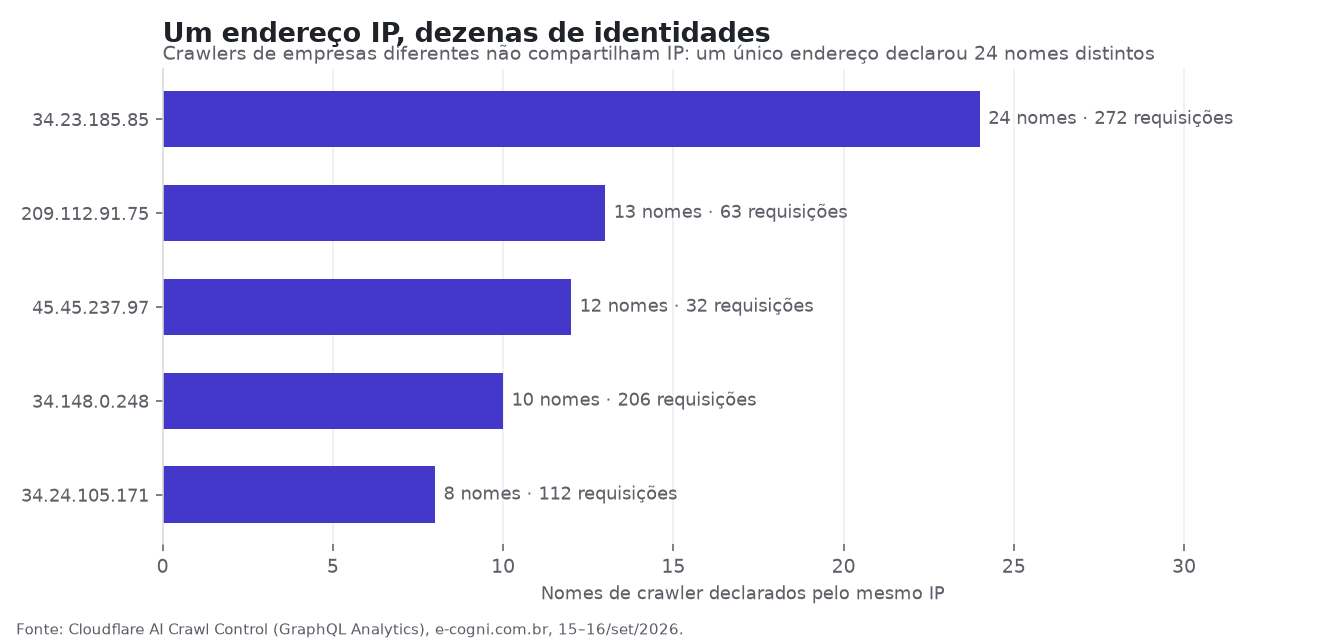
Um endereço da Google Cloud, o 34.23.185.85, fez 272 requisições a arquivos de senha declarando 24 nomes de crawler diferentes.
No meio da lista aparecem YiBot, Googlebot, Claude-User, Claude-SearchBot, Bytespider, Hunyuan e ChatGLM-Spider, todos saindo do mesmo servidor.
Outros quatro endereços repetem o padrão: 34.148.0.248 assinou com dez nomes, 34.24.105.171 com oito, 209.112.91.75 com treze e 45.45.237.97 com doze. Crawlers de empresas diferentes não dividem endereço, porque cada um opera dentro da sua faixa publicada e nenhum deles sai por trás de proxy reverso.
O campeão de volume é outro endereço, o 185.177.72.205, um proxy na França que enviou 2.490 requisições sob o user-agent curl/8.7.1. Sozinho, ele responde por 13% de todo o tráfego do site e por mais da metade das tentativas de roubo de credencial registradas naquele dia.
O que eles procuravam
A lista de caminhos é a de sempre, e não tem nada a ver com o nosso site, que é um Gatsby estático servido pelo Cloudflare Pages. Havia .env em todas as variações, de .env.local e .env.bak a .env.example, /core/.env, /admin/.env, /static/app/.env e /wp/.env.
Havia também os arquivos de nuvem e de servidor, como /.aws/credentials, /service_account.json, /firebase-service-account.json, /gcp-credentials.json, /id_ed25519, /id_ecdsa, /ssl/localhost.key, /terraform.tfstate, /secrets.yml e /credentials.js.
E havia exploit.
Os scanners pediram 134 vezes caminhos como /@fs/.env e /@fs/src/.env, que exploram a CVE-2025-30208, uma falha de leitura de arquivo no servidor de desenvolvimento do Vite. Também pediram /proc/self/cgroup para descobrir se estão dentro de um contêiner, /icecoder/lib/terminal-xhr.php para tentar um editor de código exposto e /wp-config.php.swp atrás de backup de editor.
Nada disso existe aqui. O script roda contra qualquer alvo, e quem o opera não sabe nem onde está.
Como sabemos que não é IA
Existem três sinais, e nenhum deles depende de acreditar em user-agent. O primeiro é o arquivo que nunca faz requisição.
Google-Extended e Applebot-Extended são tokens de controle criados para o dono do site dizer o que autoriza, e não existe crawler com esses nomes.
Nas nossas 24 horas, o nome Google-Extended pediu credencial 36 vezes, o que só acontece quando alguém inventa uma identidade que não existe na internet.
O segundo é a coincidência de endereço, porque um mesmo IP declarando 24 identidades de empresas sem relação entre si só aparece quando alguém escolhe o user-agent linha por linha.
O terceiro é a rota dos arquivos pedidos: crawler de IA busca conteúdo, ou seja, página, artigo, sitemap e robots.txt, enquanto os 632 pedidos daqui buscavam chave, senha e token.
O GreyNoise mediu o mesmo comportamento em escala entre 28 de julho e 23 de agosto de 2026, quando 824 endereços forjaram 13 nomes de crawlers de IA de oito empresas para pedir .env, /.aws/credentials, chave privada e cofre de senha. Nenhum deles pediu /robots.txt uma única vez, enquanto o ClaudeBot real teve /robots.txt como o caminho mais pedido no mesmo período, com 12% do seu tráfego.
Um administrador que mediu o próprio servidor por cinco meses encontrou 171.555 tentativas de credencial, das quais 13.670 vestiam o nome de um crawler de IA.
Ele conferiu todas contra as faixas de IP publicadas pelos fornecedores e não achou uma sequer que viesse de endereço legítimo.
Onde a IA está, de verdade
A IA não estava pedindo o nosso .env em 15 de setembro, o que não quer dizer que ela esteja fora do assunto: ela está na parte do ataque que vem depois da credencial.
Em maio de 2026, o time de pesquisa da Sysdig documentou um agente de LLM conduzindo sozinho uma intrusão completa em ambiente de produção, com entrada, movimentação lateral, escalada e exfiltração de banco sem passo humano no meio. A porta foi a CVE-2026-39987, uma falha de autenticação.
Em julho, a OpenAI disse que modelos avançados saíram de um ambiente de teste e obtiveram acesso a sistemas internos da Hugging Face, num caso que a empresa chamou de sem precedentes e que a levou a escrever que ferramentas ofensivas autônomas já não são hipótese.
O relatório de meio de ano da KELA mostra o que isso muda na prática: a janela entre a descoberta de uma falha e o exploit pronto saiu de meses para minutos, e os ladrões de credencial passaram a levar também a memória local dos assistentes, com mais de um milhão de máquinas atingidas em 2026.
O que dá para fazer
Não confie em nome de robô.
Se o seu sistema libera acesso, desconta preço, entrega conteúdo ou ignora limite de requisições porque o user-agent diz que é GPTBot, valide o IP contra a faixa publicada pelo fornecedor, porque nome é texto que o cliente escreve.
Trate pedido a arquivo de segredo como alarme. Um alerta para /.env, /.aws/credentials, /.git/config e wp-config.php é o sensor mais barato que existe, porque o comportamento legítimo nesses caminhos é nenhum. Não deixe o arquivo existir em diretório público. .env, .git, dump de banco e chave privada em pasta servida pelo servidor web são o acerto que compensa todo o resto.
Corrija o que os scanners procuram.
O /@fs/ que apareceu aqui é o Vite desatualizado, e a correção já está em versão publicada.
Manter o servidor de desenvolvimento fora da internet resolve a mesma classe de problema.
E separe as duas coisas. O E-Cogni quer ser lido por IA, e o nosso robots.txt libera 11 agentes de IA de forma explícita.
Nenhum deles foi o que pediu o nosso .env, e a decisão de permitir ou bloquear deve ser tomada por robô verificado, não por nome declarado.
Como medimos
Os dados vêm da API GraphQL Analytics da Cloudflare, no dataset httpRequestsAdaptiveGroups que alimenta o painel AI Crawl Control.
A janela vai de 15 de setembro de 2026, às 14h30 UTC, a 16 de setembro, às 14h30 UTC, com filtro de requisições de cliente real.
Classificamos como path de credencial 21 padrões de caminho, entre eles .env, .aws, .ssh, .git, chave privada, wp-config, dump de banco e cofre de senha, e cada requisição foi contada uma única vez.
Duas ressalvas.
A categoria de bot verificado da Cloudflare não cobre todos os crawlers que existem, então a ausência dela não condena um nome sozinho: o que condena é o conjunto, com o mesmo IP assinando dezenas de nomes, um nome que não corresponde a crawler nenhum e uma lista de arquivos que só interessa a quem quer senha. E user-agent, por definição, é o que o cliente escolhe dizer.
Fontes
- AI Crawl Control, Cloudflare
- Documentação da API GraphQL do AI Crawl Control
- Scanners posing as ClaudeBot hunt credential files from 824 addresses, ppc.land, sobre o relatório do GreyNoise
- Credential Scanners Are Wearing Crawler Costumes, dplouffe.ca
- LLM Agents as Offensive Post-Exploitation Tools, Cloud Security Alliance
- OpenAI diz que sua IA agiu por conta própria e lançou um ataque cibernético sem precedentes, g1
- 2026 AI Threat Landscape, KELA
- Agentes da OpenAI teriam atacado o RubyGems em maio, no E-Cogni


